Automação começa antes do agente
Em 5 de agosto, a Egnyte anunciou recursos que unem extração de metadados, criação de agentes e um construtor de fluxos para processos intensivos em documentos. A novidade chama atenção menos por prometer um agente que resolve tudo e mais pela base que ela coloca antes da ação: documentos precisam ganhar estrutura, respeitar permissões e atravessar regras claras.
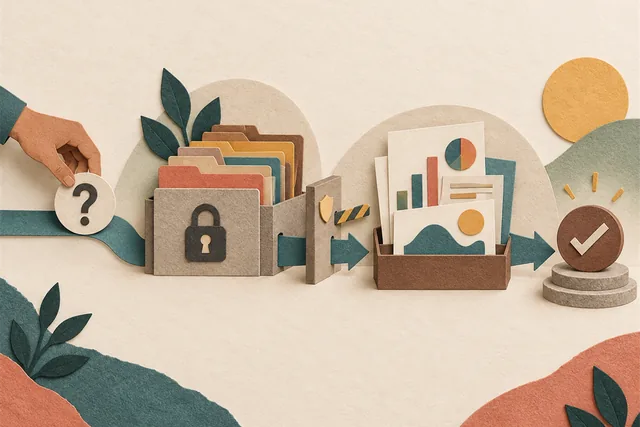
Isso é especialmente relevante em rotinas como revisão de contratos, coleta de evidências de conformidade, análise de propostas ou aprovações internas. Um modelo pode ajudar a ler muitos arquivos, mas não sabe por conta própria qual informação deve virar dado confiável, quem pode acessá-la ou em que ponto uma decisão precisa de responsável.
O que levar para o trabalho real
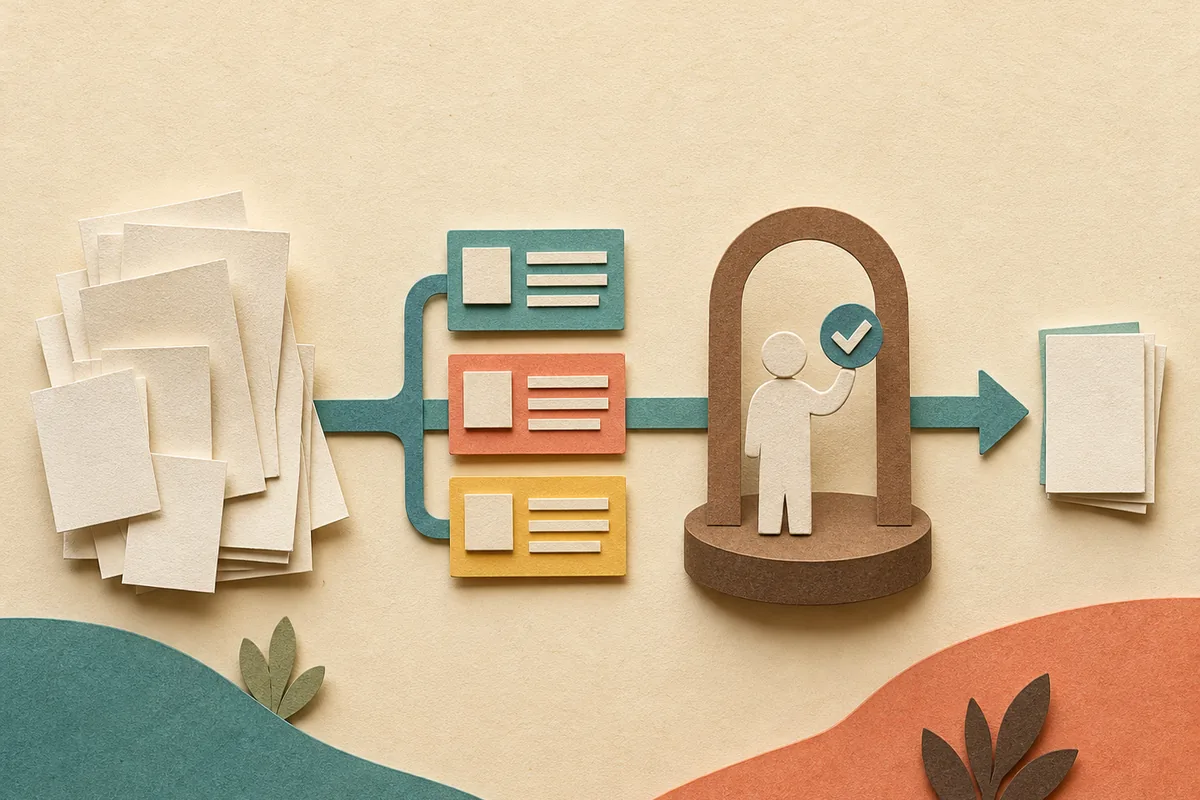
Uma automação de documentos fica mais útil quando o fluxo é desenhado em camadas. Primeiro, definir quais campos precisam ser extraídos e como serão conferidos. Depois, limitar o agente às fontes e permissões corretas. Por fim, estabelecer o que pode seguir automaticamente e o que precisa parar para uma aprovação.
Esse último ponto é o que evita uma falsa sensação de autonomia. Um checkpoint não é um atraso burocrático quando ele protege uma exceção importante: um dado incompleto, uma cláusula fora do padrão ou um documento que chegou de uma fonte errada. Ele transforma uma saída provável em uma decisão verificável.
A lição prática não depende da plataforma anunciada. Antes de conectar IA a uma pasta de arquivos, vale desenhar três coisas: quais dados entram, quais regras determinam o próximo passo e quem responde pelas exceções. Só depois faz sentido escolher agente, integração ou ferramenta de automação.
Automatizar bem não é fazer o documento desaparecer dentro de uma caixa-preta. É deixar visível como ele foi entendido, por qual regra avançou e em que momento alguém confirmou que o resultado podia seguir.